Tracker inteligente de proyectos multiproveedor
Caso de estudio · Aldana Resuche · Project Manager | AI-Assisted Operations & Automation
En una línea: automaticé la carga, la planificación y la asignación de proyectos de traducción multiproveedor con Google Sheets, Apps Script y Gemini, sin que ningún mail salga sin mi aprobación. Lo medí contra un set de prueba y llegué al 100% de 180 controles.
| Mi rol | Diseño del proceso, alcance y priorización, desarrollo, pruebas y medición (proyecto individual) |
| Duración | 2 semanas, de 1 a 2 h por día |
| Herramientas | Google Sheets · Apps Script · Gemini API · Gmail |
| Resultado | Lectura de pedidos, flujo, tareas y proveedores automatizados, con decisión humana obligatoria. 100% en un set de prueba propio de 180 controles |
1. Contexto
Casi 5 años como PM en la industria de la traducción me dejaron un patrón claro: buena parte del día se va en trabajo administrativo repetitivo, no en gestionar. Para este caso usé una empresa ficticia, Nordvia Localization, con datos 100% sintéticos y un volumen realista: unos 5 proyectos por semana, 3 idiomas en promedio y hasta 29 en un mismo proyecto.
2. El problema (proceso AS-IS)
| # | Dolor | Impacto |
|---|---|---|
| P1 | Los mismos datos se cargan 2 o 3 veces | Alrededor de 1 h por proyecto y errores de copia |
| P2 | No se controlan los datos faltantes | Se descubren tarde: un deadline ambiguo, archivos que no llegaron |
| P3 | Deadlines y prioridades se siguen a mano | Un proyecto de 29 idiomas con DTP son 146 tareas |
| P5 | No hay historial de proveedores | Se le vuelve a asignar trabajo a quien ya tuvo problemas |
| P7 | La necesidad de DTP se decide revisando cada archivo | Si se omite, aparecen errores de formato al final |
3. La solución
Un tracker en Google Sheets + Apps Script, con Gemini para entender los mails escritos por personas.
- Lectura de pedidos: las notificaciones del portal se leen con reglas (gratis, exactas e instantáneas). Los mails libres se leen con IA, que devuelve un JSON con un esquema fijo y una confianza por campo. Lo que tiene menos del 80% se marca como dudoso; lo que falta, como faltante. La IA nunca inventa: ante "next Friday", deja el deadline vacío y lo marca para el PM.
- Prioridad viva: P1 a P4 según el tiempo hasta la entrega, recalculada cada hora. Si el PM la fija a mano, el sistema respeta esa decisión.
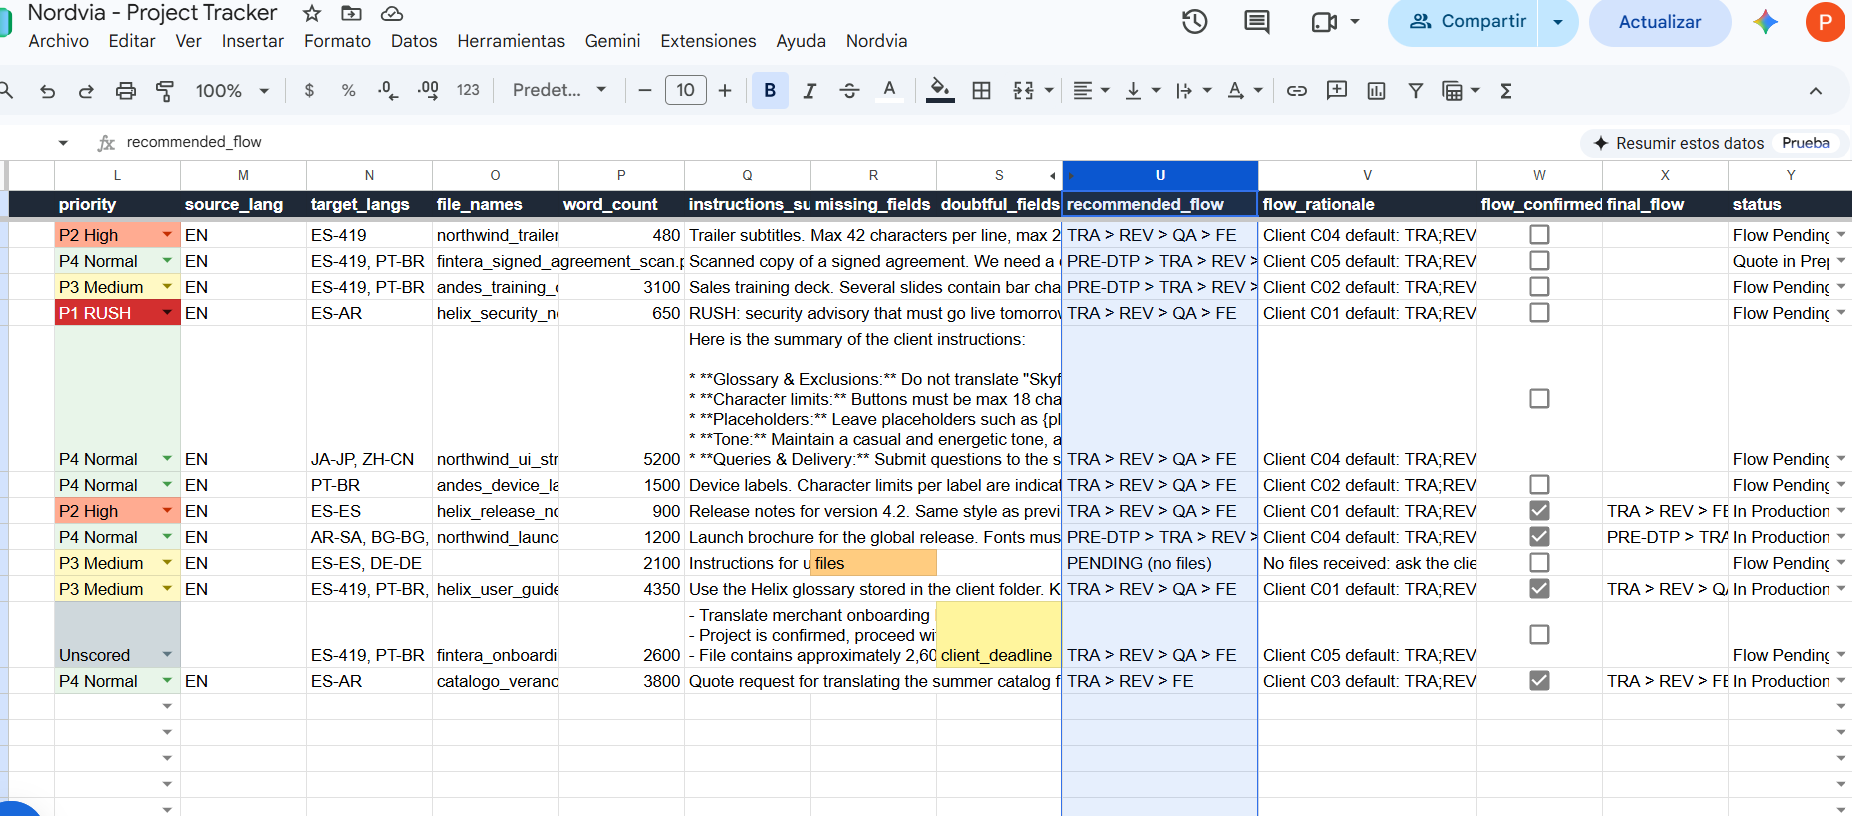
- Recomendación de flujo: una matriz de tipos de archivo más los pasos por defecto de cada cliente proponen el flujo (PRE-DTP, TRA, REV, QA, POST-DTP, Final Eye) con su justificación. El PM siempre confirma.
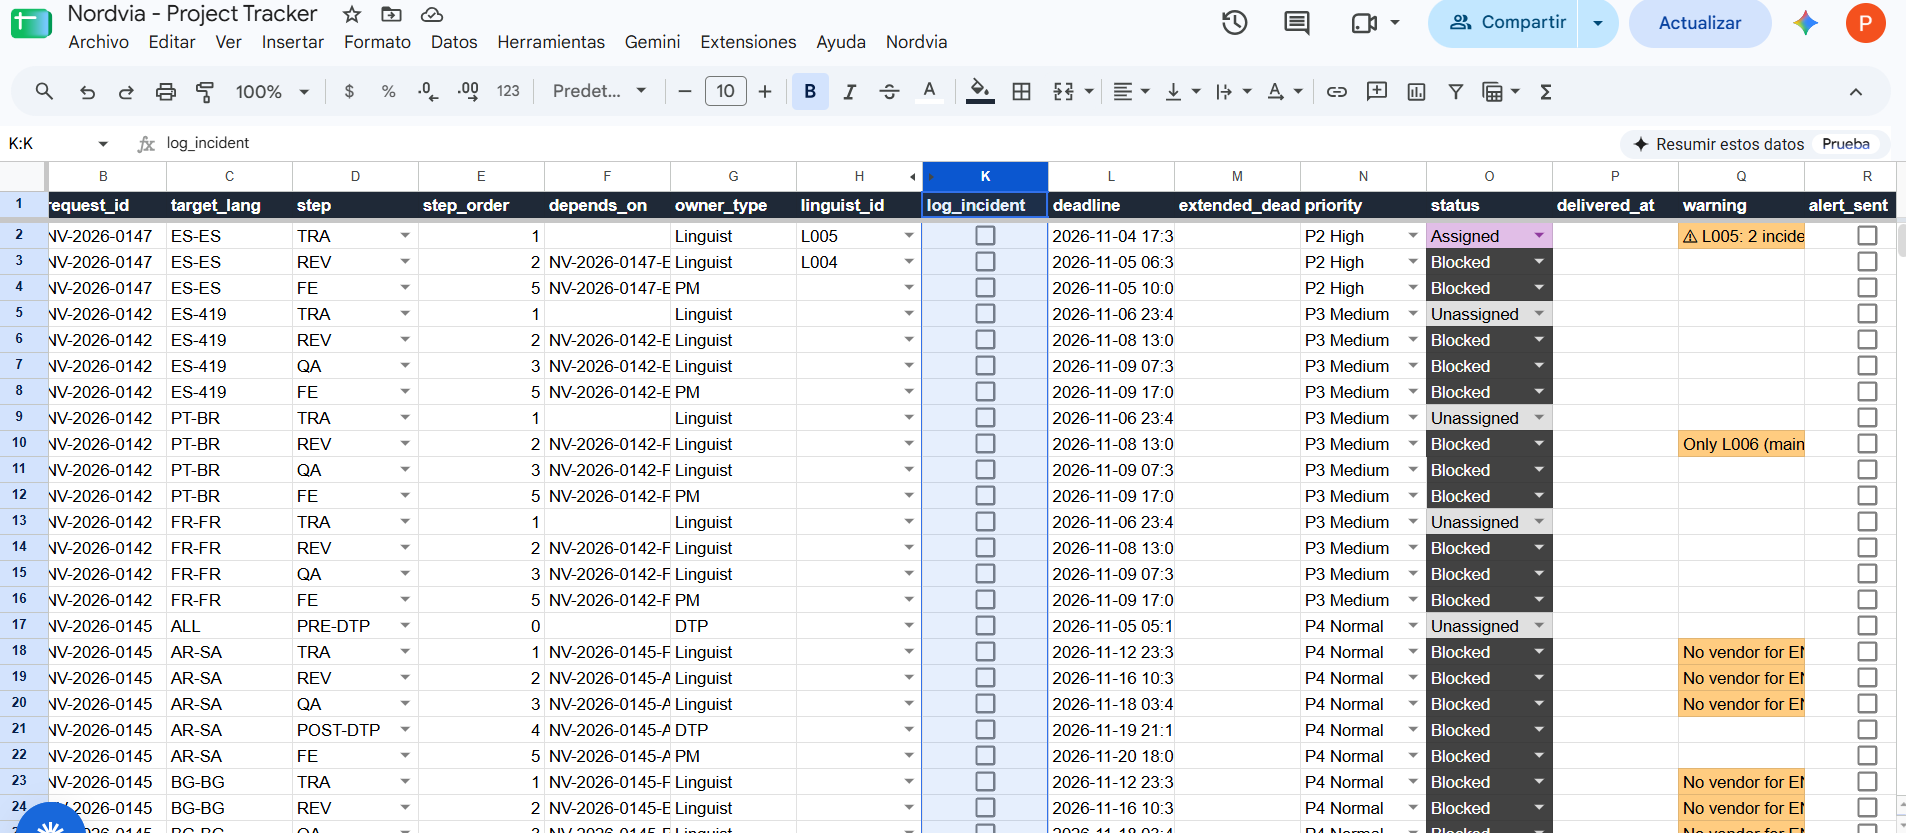
- Generación de tareas: al confirmar, se crean las tareas por idioma y paso, con dependencias y deadlines planificados hacia atrás desde la entrega al cliente. 146 tareas en segundos.
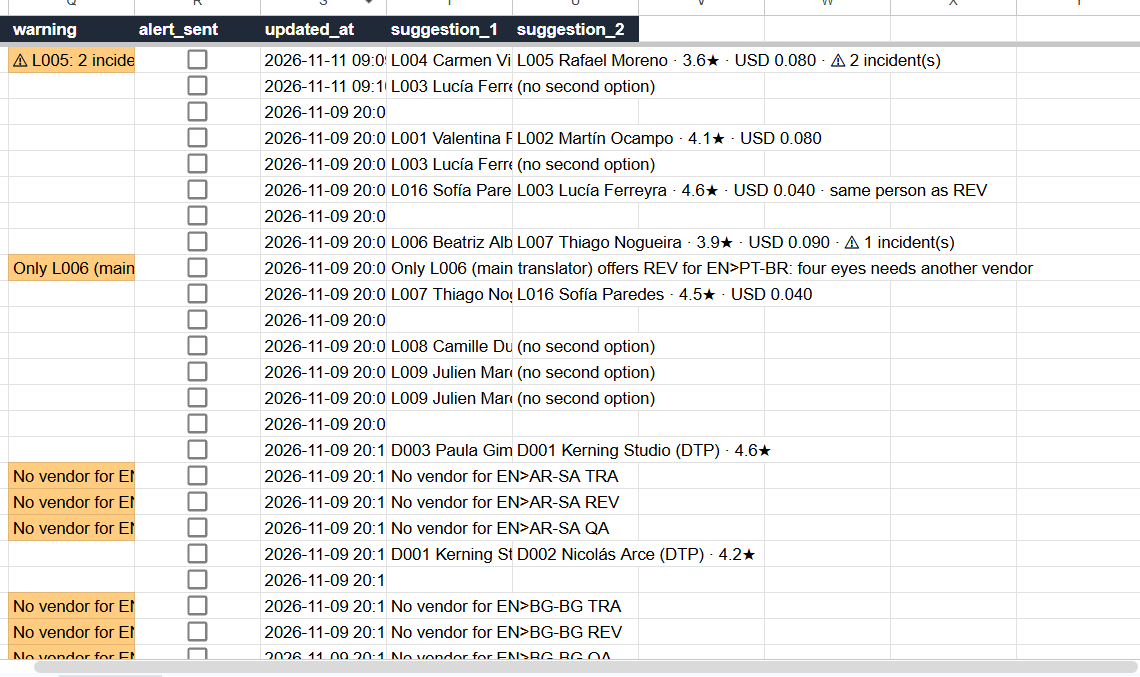
- Sugerencia de proveedores y memoria: dos opciones por paso (titular y suplente), la regla de cuatro ojos de ISO 17100 (quien revisa no es quien tradujo) y avisos visibles al asignar: ⚠ incidentes de los últimos 6 meses, 💲 tarifa por encima de la mediana y ⛔ par o paso no cubierto.
4. Cómo lo gestioné como proyecto
- Descubrimiento: mapeé el proceso AS-IS a partir de mi experiencia, identifiqué 8 dolores (P1 a P8) y diseñé el TO-BE con diagramas antes de escribir una línea de código.
- Alcance: prioricé con MoSCoW y separé una v1 entregable de una v2. Cuando el calendario se ajustó, recorté el alcance (portfolio primero) en lugar de la calidad.
- Stakeholders: el sistema contempla a los dos lados de la operación. Para los clientes: detección de datos faltantes, cotización contra orden y aviso de costo extra en PDF escaneados. Para los proveedores: sugerencias, memoria de incidentes, tarifas y la regla de cuatro ojos. Nada se le comunica a ninguno de los dos sin la aprobación del PM.
- Decisiones trazables: llevé una bitácora de 62 decisiones, cada una con su contexto y su porqué, incluidos los errores y cómo se corrigieron.
- Entrega iterativa: trabajé en bloques cortos (lectura → flujo → tareas → proveedores). Cada bloque se instaló, se probó con el usuario y se midió antes de pasar al siguiente.
- Gestión de riesgos: armé un registro de riesgos (R1 a R7) con planes de contingencia. Cuando dos se materializaron (el proveedor dio de baja el modelo y después se saturó), se absorbieron por configuración y con un respaldo automático, sin frenar el proyecto.
- Adopción: definí RACI, plan piloto y contingencia (un interruptor manual para apagar la automatización). La herramienta está pensada para que el PM confíe en ella: explica cada recomendación y nunca decide por él.
- Calidad y cumplimiento: regla de cuatro ojos de ISO 17100, gobierno de datos alineado con GDPR y la Ley 25.326 (datos mínimos, la clave de la IA fuera de la hoja, registro de auditoría) y criterios de ISO/IEC 42001 para el uso responsable de IA.
5. Decisiones de diseño
- Human in the loop: la máquina recomienda y el PM decide. No hay envíos automáticos ni confirmaciones automáticas. Toda diferencia entre lo recomendado y lo decidido queda registrada.
- Reglas primero, IA después: la IA solo se usa donde aporta (texto libre). Es más barato, más predecible y más fácil de explicar.
- Resiliencia: el modelo se configura desde una hoja. Cuando Google dio de baja el modelo en uso, se resolvió sin tocar código. Cuando el proveedor se saturó, se sumó un modelo de respaldo automático.
- Idempotencia y concurrencia: procesar dos veces no duplica nada. Un doble clic real generó un duplicado en las pruebas, y eso llevó a sumar un candado y un control por hilo de Gmail.
- Gobierno de datos: la clave de la IA nunca está en la hoja ni en el registro, hay un registro de auditoría de cada acción y los datos son ficticios.
6. Cómo se midió
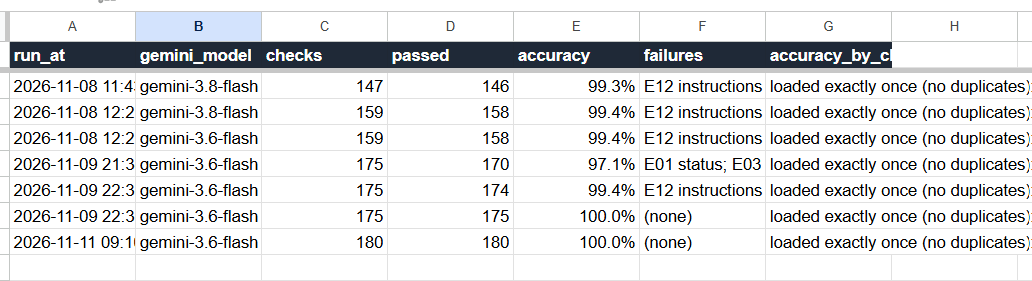
Armé un set de prueba con 13 escenarios (normal, sin archivos, cotización, 29 idiomas, deadline ambiguo, RUSH, DTP, PDF escaneado, subtítulos y un newsletter que hay que ignorar) con la respuesta esperada para cada campo. Un script compara el resultado con lo esperado y guarda un historial por versión:
| Versión | Acierto | Qué enseñó |
|---|---|---|
| v1 | 99,3% | El proveedor de IA se saturó (503). La contingencia conservó el texto original |
| v3 | 97,1% | Los controles también se equivocan: 5 fallas eran errores de diseño de la evaluación, no del sistema |
| v4 | 100% (180/180) | Lectura, flujo, tareas, proveedores y memoria de proveedores |
Límite: el set de prueba lo diseñé yo, con 13 escenarios. Sirve para detectar regresiones, pero no prueba que el sistema generalice. El próximo paso es un set ciego con pedidos escritos por otra persona.
7. Resultados
- Medido: 100% de acierto en el set de prueba. 146 tareas generadas en segundos en el caso de 29 idiomas. 0 duplicados después del arreglo de concurrencia. 0 falsos positivos.
- Estimado (con mi experiencia, todavía sin validar con cronómetro): con el sistema completo, la gestión por proyecto bajaría de 5,9 h a 2,7 h (−54%). Eso duplica la capacidad, de 5 a 10 proyectos por semana, sin sumar personas. En tiempo liberado del PM equivale a ≈ USD 300 por semana · ≈ USD 1.300 por mes · ≈ USD 14.400 por año (48 semanas). Gestionar ese volumen extra contratando a otro PM costaría unos USD 680 por semana.
La v1 cubre la lectura, el flujo, las tareas y los proveedores. La estimación de ahorro corresponde al sistema completo, que en la v2 suma alertas y plantillas.
8. Lecciones
- Medir antes de afirmar: sin el set de prueba, la falla del proveedor de IA y los controles mal diseñados habrían pasado desapercibidos.
- Un control de evaluación es código y también se prueba. Medir un resumen por su largo da falsos negativos; hay que medir lo que se le pidió a la IA.
- El PM no se reemplaza, se potencia: cada automatización deja la decisión final y la información a la vista.
9. Próximos pasos (v2)
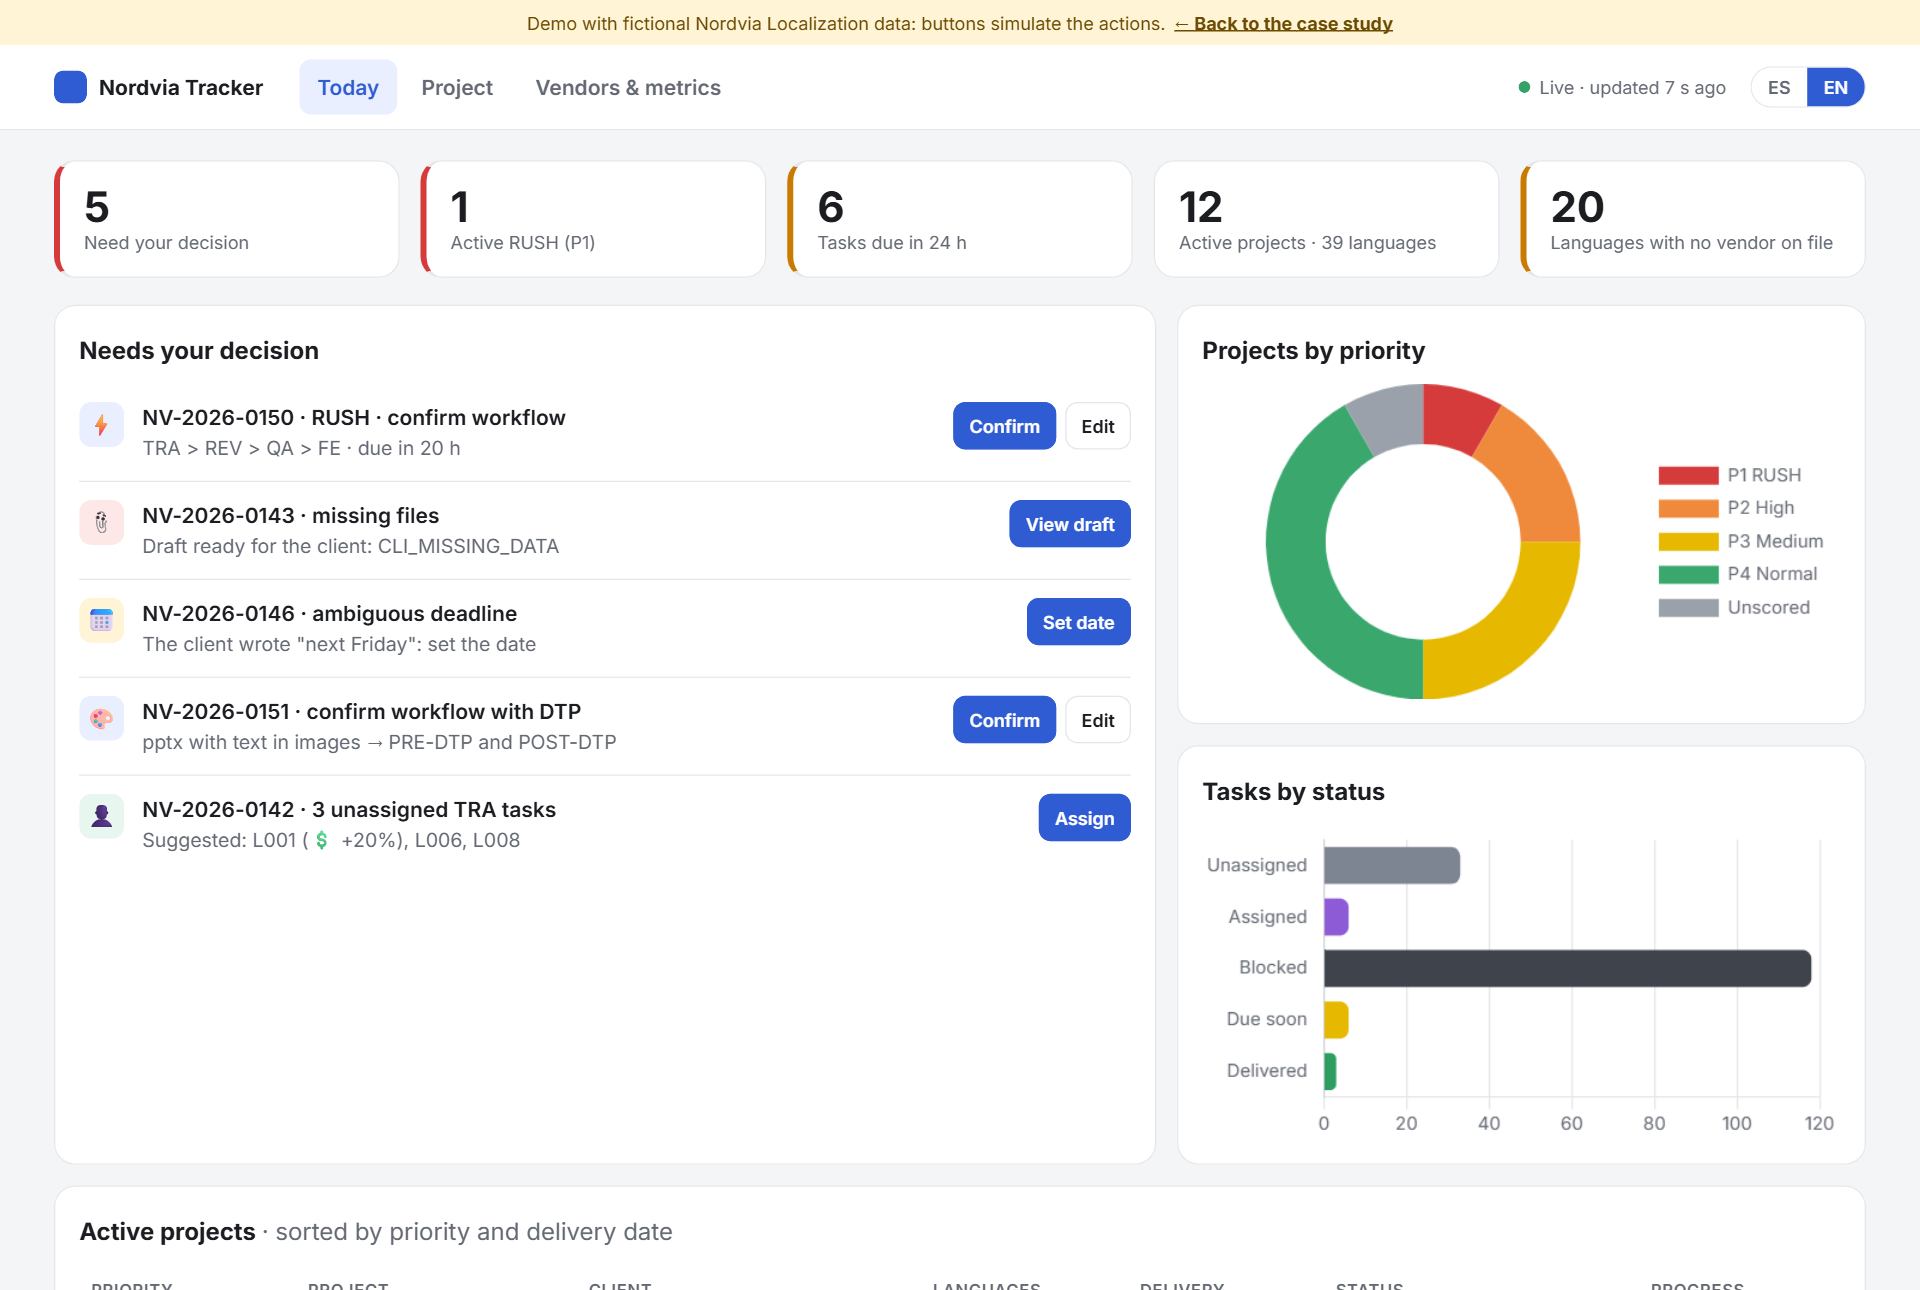
Hecho después de la v1: interfaz web del tracker (dashboard bilingüe con métricas y decisiones del día), disponible como demo.
Siguientes: medición con cronómetro · integración con n8n: monitor de entregas y extensiones · migración a una app web con base de datos propia, para validar que el modelo escala más allá de una planilla · plantillas de mails como borradores · análisis real de imágenes en los archivos · Proyecto 2: hoja de rentabilidad y riesgo.
Stack: Google Sheets · Apps Script · Gemini API (salida estructurada) · Gmail · 9 módulos, unas 2.150 líneas · documentación de procesos, RACI, riesgos y gobierno de datos.